LLM Context Window Optimization: Strategies for Speed, Cost, and Accuracy
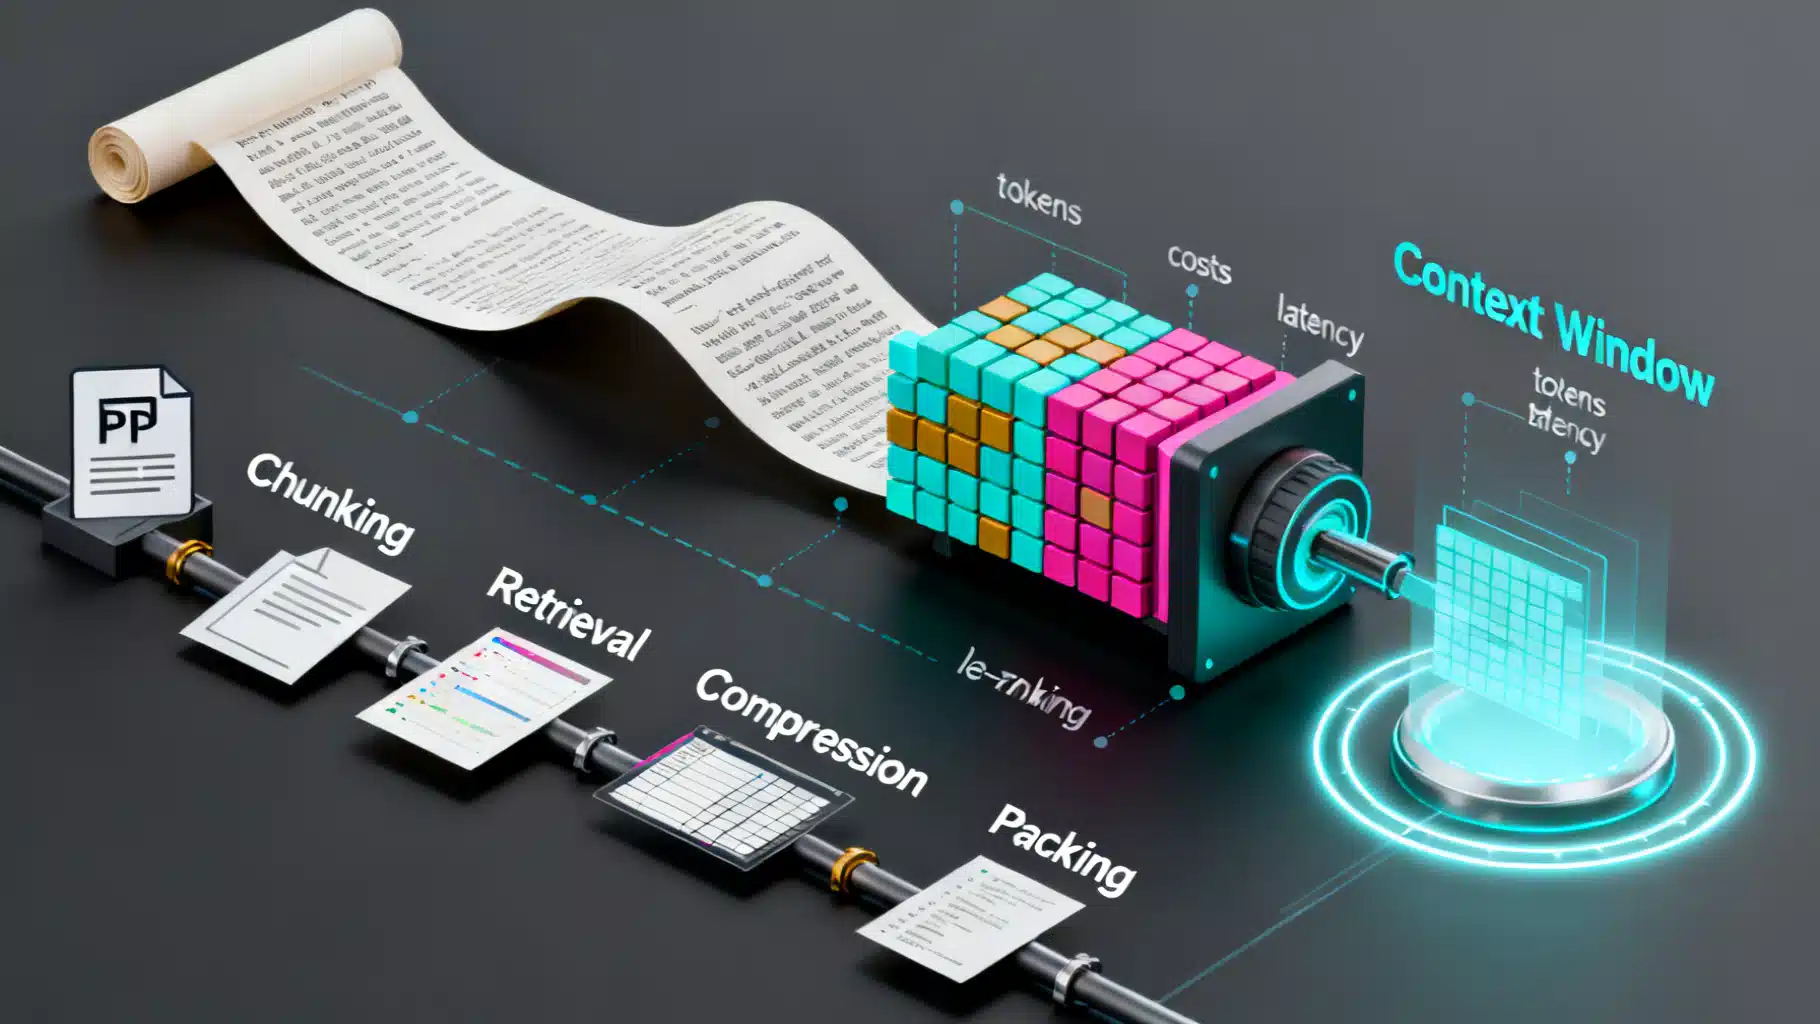
Practical strategies to optimize LLM context windows—reduce cost and latency while preserving accuracy with RAG, chunking, compression, caching, and evaluation.
Use Stable Diffusion APIs in production: concepts, parameters, code examples, scaling, safety, and cost optimization.
A practical blueprint for preventing prompt injection in LLM apps: threat models, mitigations, code patterns, testing, and operations.
A practical guide to integrating an AI writing assistant via API—architecture, prompt design, code samples, safety, evaluation, and performance optimization.
A practical tutorial on reasoning models and chain-of-thought: safe prompting, self-consistency, tree-of-thought, tooling, and evaluation patterns.
A practical, end-to-end guide to reducing AI hallucinations with data, training, retrieval, decoding, and verification techniques.